PostgreSQL-Job-Queues brauchen Leases, nicht nur SKIP LOCKED
So entsteht eine zuverlässige PostgreSQL-Job-Queue mit atomarer Reservierung, ablaufenden Leases, Fencing-Tokens, begrenzten Retries, Beobachtbarkeit und Tests mit gezielt ausgelösten Fehlern.
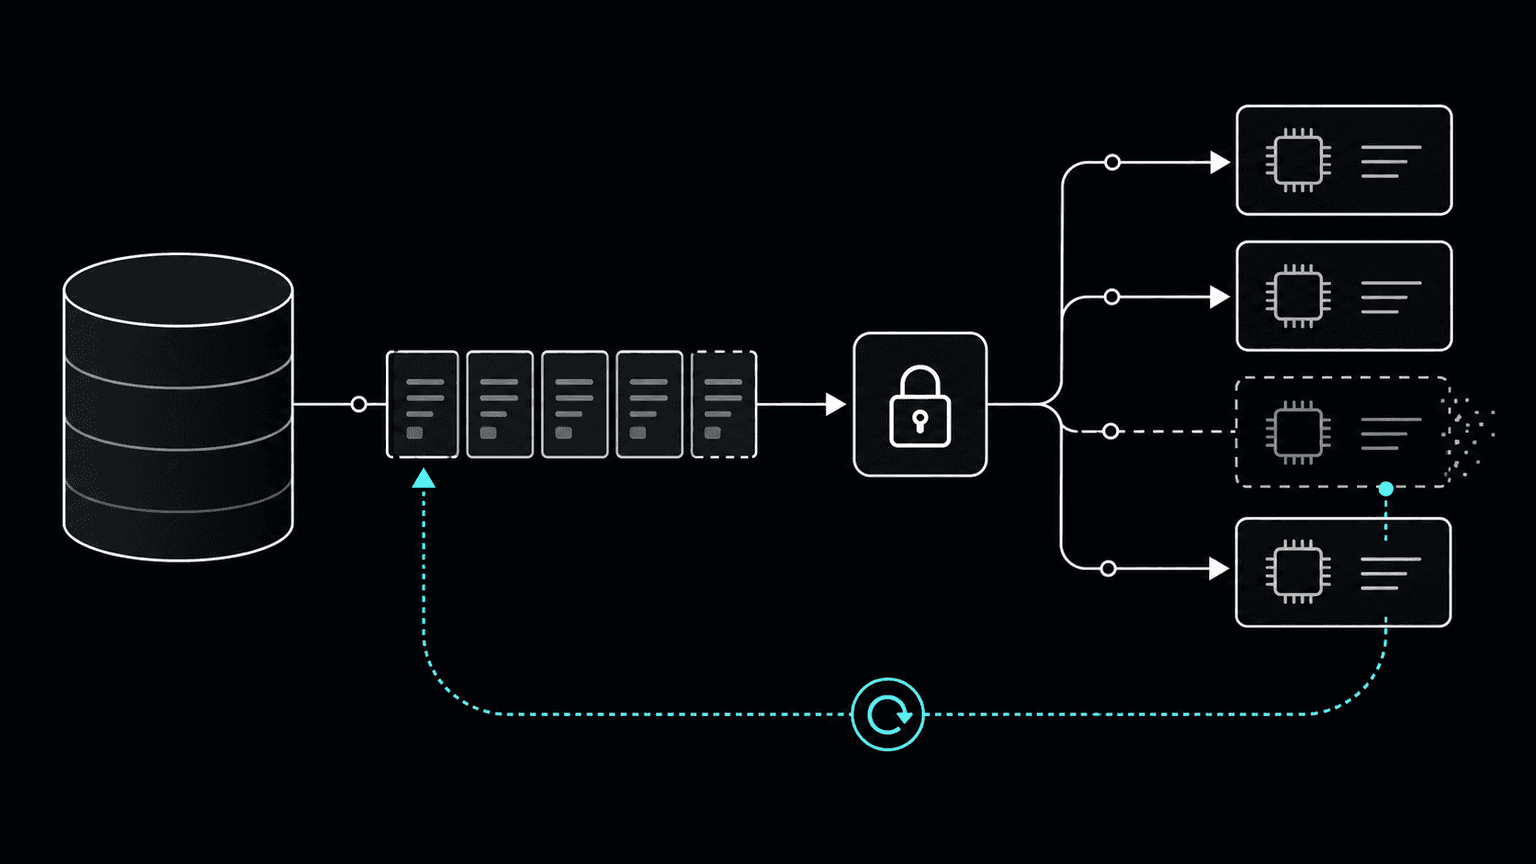
FOR UPDATE SKIP LOCKED ist ein nützlicher Mechanismus zur Nebenläufigkeitskontrolle, aber keine vollständige Job-Queue. Die Klausel kann verhindern, dass zwei Worker dieselbe Zeile innerhalb einer Transaktion reservieren. Sie kann weder Arbeit nach dem Absturz eines Workers wiederherstellen noch verhindern, dass ein veralteter Worker verspätet committet. Ebenso wenig entscheidet sie über Retries oder beweist, dass ein externer Seiteneffekt genau einmal eingetreten ist.
Eine zuverlässige PostgreSQL-Queue braucht um diesen Mechanismus herum eine Zustandsmaschine. Der Worker sollte Jobs atomar reservieren, eine ablaufende Lease statt eines dauerhaften Besitz-Flags halten, bei jedem Abschluss ein Fencing-Token mitführen und genügend dauerhaften Zustand für Wiederherstellung und Betrieb hinterlassen.
Dieser Artikel entwickelt diesen Entwurf als Referenzarchitektur. Er beansprucht kein gemessenes Produktions-Deployment.
Die Sperre endet vor der Arbeit#
PostgreSQL dokumentiert SKIP LOCKED als inkonsistente Sicht, die für allgemeine Lesezugriffe ungeeignet ist, aber mehreren Consumern den Zugriff auf eine queue-artige Tabelle ermöglicht. Genau dafür ist die Klausel gedacht: Parallele Worker können bereits von anderen Workern gesperrte Zeilen überspringen, statt auf sie zu warten.
Ein häufiger Fehler besteht darin, die Datenbanktransaktion während der gesamten Job-Ausführung offen zu halten:
BEGIN;

SELECT *
FROM jobs
WHERE status = 'pending'
ORDER BY available_at, id
FOR UPDATE SKIP LOCKED
LIMIT 1;

-- call a remote API, render a file, or run a model

DELETE FROM jobs WHERE id = $1;
COMMIT;
Damit erhält die Zeilensperre dieselbe Lebensdauer wie die Arbeit. Eine langsame Abhängigkeit führt nun zu einer langen Transaktion. Lange Transaktionen halten Sperren, verzögern die Bereinigung, belegen Verbindungen und koppeln die Wiederherstellung nach einem Fehler an eine Datenbanksitzung. Außerdem können sie einen Remote-API-Aufruf nicht in die PostgreSQL-Transaktion einbeziehen.
Die sicherere Grenze ist kurz: Die Zeile reservieren und sofort committen. Der Worker verarbeitet sie anschließend außerhalb der Transaktion. Daraus folgt eine neue Anforderung. Nach Freigabe der Zeilensperre muss der dauerhafte Queue-Zustand festhalten, wem der Job gehört und wann dieser Besitz abläuft.
Eine Lease statt einer dauerhaften Reservierung modellieren#
Ein kompaktes Schema kann die wesentlichen Zustände ausdrücken:
CREATE TYPE job_status AS ENUM (
  'pending', 'running', 'succeeded', 'dead'
);

CREATE TABLE jobs (
  id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  queue_name text NOT NULL,
  payload jsonb NOT NULL,
  status job_status NOT NULL DEFAULT 'pending',
  priority integer NOT NULL DEFAULT 0,
  available_at timestamptz NOT NULL DEFAULT now(),
  attempt_count integer NOT NULL DEFAULT 0,
  max_attempts integer NOT NULL DEFAULT 8,
  lease_owner text,
  lease_token bigint NOT NULL DEFAULT 0,
  lease_expires_at timestamptz,
  last_error_code text,
  created_at timestamptz NOT NULL DEFAULT now(),
  finished_at timestamptz
);

CREATE INDEX jobs_claimable_idx
  ON jobs (queue_name, priority DESC, available_at, id)
  WHERE status = 'pending';

CREATE INDEX jobs_expired_lease_idx
  ON jobs (lease_expires_at)
  WHERE status = 'running';
lease_expires_at macht Besitz zeitlich begrenzt. lease_token ist eine Generationsnummer. Jede erfolgreiche Reservierung erhöht sie, sodass der aktuelle Worker seine Lease von einer älteren unterscheiden kann, selbst wenn beide Prozesse glauben, denselben Job zu besitzen.
Die Payload sollte die zur Job-Ausführung erforderlichen Daten enthalten, aber keine uneingeschränkten Zugangsdaten. Secrets bleiben hinter serverseitigen Referenzen mit Zugriffskontrollen und Rotation.
Reservierung und Zustandsübergang in einer Anweisung ausführen#
Wählen Sie nicht in einer Transaktion eine ID aus, um sie in einer anderen zu aktualisieren. Zwischen beiden Operationen kann ein anderer Worker dieselbe Zeile reservieren. Verwenden Sie eine sperrende Unterabfrage und ein Update in einer einzigen Anweisung:
WITH candidate AS (
  SELECT id
  FROM jobs
  WHERE queue_name = $1
    AND status = 'pending'
    AND available_at <= now()
  ORDER BY priority DESC, available_at, id
  FOR UPDATE SKIP LOCKED
  LIMIT 1
)
UPDATE jobs AS j
SET status = 'running',
    attempt_count = attempt_count + 1,
    lease_owner = $2,
    lease_token = lease_token + 1,
    lease_expires_at = now() + interval '60 seconds'
FROM candidate
WHERE j.id = candidate.id
RETURNING j.*;
Die Anweisung läuft innerhalb einer kurzen Transaktion. Bei PostgreSQLs standardmäßiger Isolationsstufe Read Committed sieht jeder Befehl einen Snapshot vom Beginn des Befehls, während die Sperrklausel parallele Zeilenaktualisierungen entsprechend dem dokumentierten Row-Locking-Verhalten auflöst. Die entscheidende Eigenschaft stammt hier von der Zeilensperre und dem atomaren Update, nicht von der Annahme eines wiederholbaren Snapshots.
Einen einzelnen Job zu reservieren ist einfach. Ein Batch kann Roundtrips reduzieren, erhöht aber die Menge unsichtbarer Arbeit, die ein Worker hält. Halten Sie Batches begrenzt und kleiner als die Arbeitsmenge, die ein Worker innerhalb des Lease-Zeitfensters abschließen kann.
Das Lease-Token als Fence verwenden#
Eine ablaufende Lease erzeugt eine Race Condition:
- Worker A reserviert Job 42 mit Token 7.
- A pausiert so lange, dass die Lease abläuft.
- Die Wiederherstellung setzt den Job auf
pendingzurück. - Worker B reserviert ihn mit Token 8 und schließt ihn ab.
- A läuft weiter und versucht, Erfolg zu melden.
Eine Prüfung nur anhand von job_id würde A erlauben, den Zustand von B zu überschreiben. Das Abschluss-Update muss das Token einschließen:
UPDATE jobs
SET status = 'succeeded',
    finished_at = now(),
    lease_owner = NULL,
    lease_expires_at = NULL
WHERE id = $1
  AND status = 'running'
  AND lease_owner = $2
  AND lease_token = $3
  AND lease_expires_at > now();
Ein Update von null Zeilen bedeutet, dass der Worker die Lease nicht mehr besitzt. Er darf den Job nicht als abgeschlossen markieren.
Diese Fencing-Prüfung schützt den Queue-Zustand. Sie grenzt ein externes System nicht automatisch ab. Sendet der Job eine Zahlungsanfrage, E-Mail, einen Webhook oder einen Schreibvorgang an einen Object Store, übergeben Sie einen stabilen Idempotency-Key, sofern das Ziel einen unterstützt. Andernfalls wird die externe Aktion als dauerhafter Zustand mit einem Ergebnis uncertain und einem Abgleich modelliert. Ein Datenbank-Token kann keinen Seiteneffekt zurücknehmen, der seine Transaktionsgrenze bereits verlassen hat.
Nur bei Fortschritt verlängern#
Manche Jobs laufen berechtigterweise länger als die ursprüngliche Lease. Ein Worker kann per Heartbeat den Ablauf verlängern, erneut geschützt durch Besitzer und Token:
UPDATE jobs
SET lease_expires_at = now() + interval '60 seconds'
WHERE id = $1
  AND status = 'running'
  AND lease_owner = $2
  AND lease_token = $3
  AND lease_expires_at > now();
Verlängern Sie eine Lease nicht unbegrenzt, nur weil der Prozess noch läuft. Koppeln Sie die Verlängerung nach Möglichkeit an nachweisbaren Fortschritt: einen abgeschlossenen Abschnitt, einen fortgeschrittenen Cursor oder eine kürzlich eingegangene Bestätigung des nachgelagerten Systems. Legen Sie zusätzlich zur fortlaufenden Lease eine maximale Laufzeit fest. So kann ein fachlich festgefahrener Worker einen Job nicht dauerhaft monopolisieren.
Verwenden Sie für Lease-Vergleiche die Zeit der Datenbank. Vermischte Worker-Uhren bringen Clock Skew in Besitzentscheidungen.
Aufgegebene Arbeit mit einer begrenzten Richtlinie wiederherstellen#
Ein Wiederherstellungsjob sollte abgelaufene laufende Jobs suchen und sich entweder für einen Retry oder einen endgültigen Fehler entscheiden:
UPDATE jobs
SET status = CASE
      WHEN attempt_count >= max_attempts THEN 'dead'::job_status
      ELSE 'pending'::job_status
    END,
    available_at = CASE
      WHEN attempt_count >= max_attempts THEN available_at
      ELSE now() + interval '30 seconds'
    END,
    lease_owner = NULL,
    lease_expires_at = NULL,
    last_error_code = 'LEASE_EXPIRED'
WHERE status = 'running'
  AND lease_expires_at <= now();
Die gezeigte Verzögerung dient nur als Beispiel. Tatsächlicher Backoff sollte Jitter, eine maximale Verzögerung und ein Budget enthalten, das sich am Wiederherstellungsverhalten der Abhängigkeit sowie am Latenzziel des Workflows orientiert.
Klassifizieren Sie Fehler vor dem Retry. Ungültige Payloads und nicht unterstützte Schemaversionen werden sich kaum verbessern. Timeouts und kurze Ausfälle einer Abhängigkeit möglicherweise schon. Unbekannte Exceptions verdienen ein kleines Budget und vollständige Diagnosedaten, keine unbegrenzten Versuche.
Ein dead-Job ist keine gelöschte Information. Er ist ein betrieblicher Zustand mit Besitzer, Aufbewahrungsrichtlinie, Prüfpfad und kontrolliertem Replay-Verfahren. Ein Replay darf Arbeit erst neu erstellen oder zurücksetzen, nachdem die Fehlerursache behoben wurde, und muss die ursprüngliche Job-Identität sowie den Audit-Trail erhalten.
Reihenfolge und Fairness sind getrennte Anforderungen#
ORDER BY priority DESC, available_at, id gibt Workern eine deterministische Präferenz, aber keine strikte globale Reihenfolge. SKIP LOCKED lässt einen Worker bewusst eine frühere gesperrte Zeile überspringen. Ein dauerhafter Strom hoch priorisierter Jobs kann außerdem Arbeit mit niedriger Priorität verhungern lassen.
Wenn die Reihenfolge pro Aggregat relevant ist, muss sie explizit codiert werden. Eine Möglichkeit besteht darin, nur die niedrigste Sequenznummer eines Aggregats reservierbar zu machen. Eine andere leitet jedes Aggregat an einen seriellen Executor. Beide Ansätze verringern die Nebenläufigkeit und benötigen Tests für Lücken und nicht verarbeitbare Jobs.
Fairness lässt sich über alterungsbasierte Priorität, Queue-spezifische Worker-Pools oder gewichtetes Scheduling erreichen. Versprechen Sie nicht allein deshalb FIFO, weil die Reservierungsabfrage ein ORDER BY enthält.
LISTEN und NOTIFY sind Wecksignale, kein Speicher#
Die Tabelle ist die dauerhafte Source of Truth; Polling fragt sie lediglich ab. Ein aggressives Polling-Intervall erzeugt bei leerer Queue jedoch unnötige Datenbankarbeit. PostgreSQL NOTIFY kann wartende Worker wecken, nachdem eine Enqueue-Transaktion committet wurde. Laut Dokumentation werden Benachrichtigungen innerhalb einer Transaktion erst nach dem Commit zugestellt.
Nutzen Sie dies als Latenzoptimierung:
- Die dauerhafte Job-Zeile einfügen.
pg_notifyin derselben Transaktion aufrufen.- Worker nach dem Commit wecken.
- Die Jobs-Tabelle stets nach tatsächlicher Arbeit abfragen.
- Regelmäßig pollen, um verpasste Benachrichtigungen oder getrennte Listener aufzufangen.
Die Notification-Payload ist nicht die Queue. Ein Worker, der offline war, muss weiterhin jeden dauerhaften Job in der Tabelle finden können.
Die Zustandsmaschine betreiben#
Aussagekräftige Metriken beschreiben Alter und Übergänge, nicht nur die Anzahl der Zeilen:
- Alter des ältesten reservierbaren Jobs;
- Reservierungs- und Abschlusslatenz je Queue;
- laufende Jobs kurz vor Ablauf ihrer Lease;
- Lease-Abläufe und durch Fencing zurückgewiesene Abschlussversuche;
- Retries nach Fehlercode und Versuchsnummer;
- endgültig fehlgeschlagene Jobs und Alter des ältesten ungelösten Fehlers;
- Heartbeat-Fehler;
- Dauer der Reservierungsabfrage, Lock Waits und Nutzung von Datenbankverbindungen;
- Worker-Durchsatz und -Sättigung.
Alarmieren Sie bei alter Arbeit. Auch eine kleine Queue kann defekt sein, wenn sich ihr ältester Job seit einer Stunde nicht bewegt hat. Begrenzen Sie Payloads und Fehlerfelder und beachten Sie den Datenschutz. Betriebliche Transparenz erfordert nicht, sensible Eingaben in Logs zu kopieren.
Abstürze an jeder Grenze testen#
Die aussagekräftigsten Tests unterbrechen den Lebenszyklus gezielt:
- Mehrere Worker gleichzeitig reservieren lassen und prüfen, dass jede mit einem Token versehene Lease eindeutig ist.
- Nach dem Commit der Reservierung, aber vor der Verarbeitung abstürzen und anschließend Ablauf sowie erneute Reservierung prüfen.
- Worker A pausieren, Worker B übernehmen lassen und prüfen, dass As veralteter Abschluss null Zeilen aktualisiert.
- Nach einem externen Seiteneffekt, aber vor Abschluss des Queue-Eintrags abstürzen und die Idempotenz- oder Abgleichsrichtlinie prüfen.
- Heartbeats während laufender Arbeit verlieren und das maximale Zeitfenster für Mehrfachausführung prüfen.
- Retries ausschöpfen und einen sichtbaren Endzustand statt einer Löschung nachweisen.
- Einen Job gesperrt halten und prüfen, dass unabhängige Jobs über
SKIP LOCKEDweiterlaufen. - Eine Klasse hoher Priorität überlasten und die gewählte Fairness-Richtlinie testen.
- Alle Listener trennen und nachweisen, dass regelmäßiges Polling committete Jobs weiterhin abarbeitet.
- Einen ausreichend großen Rückstau erzeugen, um Query-Pläne, Indexverhalten und Wiederherstellungsdurchsatz zu untersuchen.
Diese Tests definieren, was "zuverlässig" bedeutet. Der SQL-Mechanismus allein tut es nicht.
Praktisches Fazit#
PostgreSQL kann eine starke Grundlage für Job-Queues sein, wenn der Workload von transaktionalem Enqueueing, überschaubarem Betriebsaufwand und direkter Prüfung per SQL profitiert. Entscheidend ist, die Garantien eng zu begrenzen.
Verwenden Sie FOR UPDATE SKIP LOCKED, um kurze atomare Reservierungen zu koordinieren. Committen Sie, bevor langsame Arbeit beginnt. Bilden Sie Besitz als ablaufende Lease ab, erhöhen Sie bei jeder Reservierung ein Fencing-Token und verlangen Sie dieses Token bei Heartbeat und Abschluss. Begrenzen Sie Retries, behalten Sie endgültig fehlgeschlagene Jobs, behandeln Sie NOTIFY als optionalen Weckpfad und gestalten Sie externe Effekte idempotent oder abgleichbar.
Eine Queue ist nicht deshalb zuverlässig, weil zwei Worker dieselbe Zeile meiden. Sie ist zuverlässig, wenn jeder Absturz genügend dauerhaften Zustand hinterlässt, damit ein anderer Prozess über den nächsten Schritt entscheiden kann.